英伟达发布全栈协同设计,提升AI推理每美元吞吐量

英伟达在11月5日发布技术解读,聚焦AI推理中HBM资源压力。随着大模型参数规模及智能体应用扩展,GPU显存需承载模型权重与KV缓存。部分场景处理多达300万个token,加上检索增强生成(RAG)引……

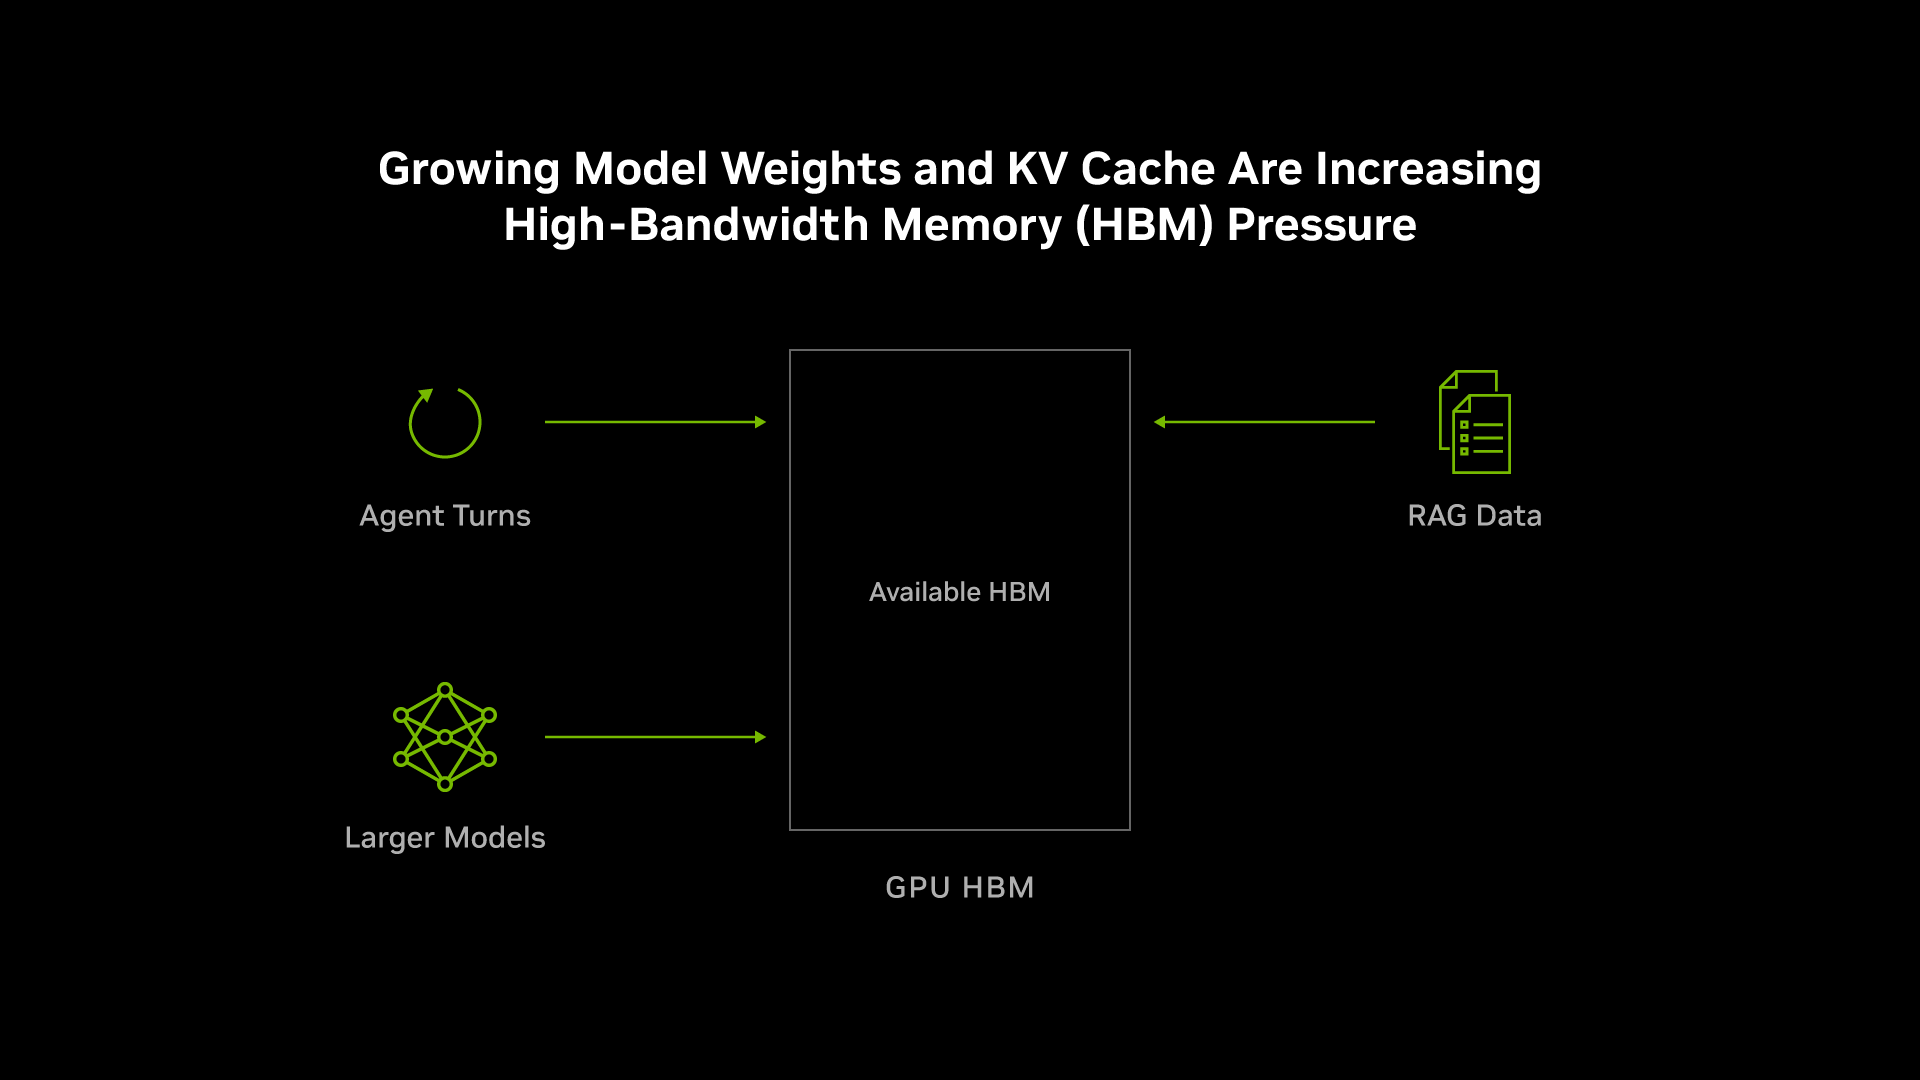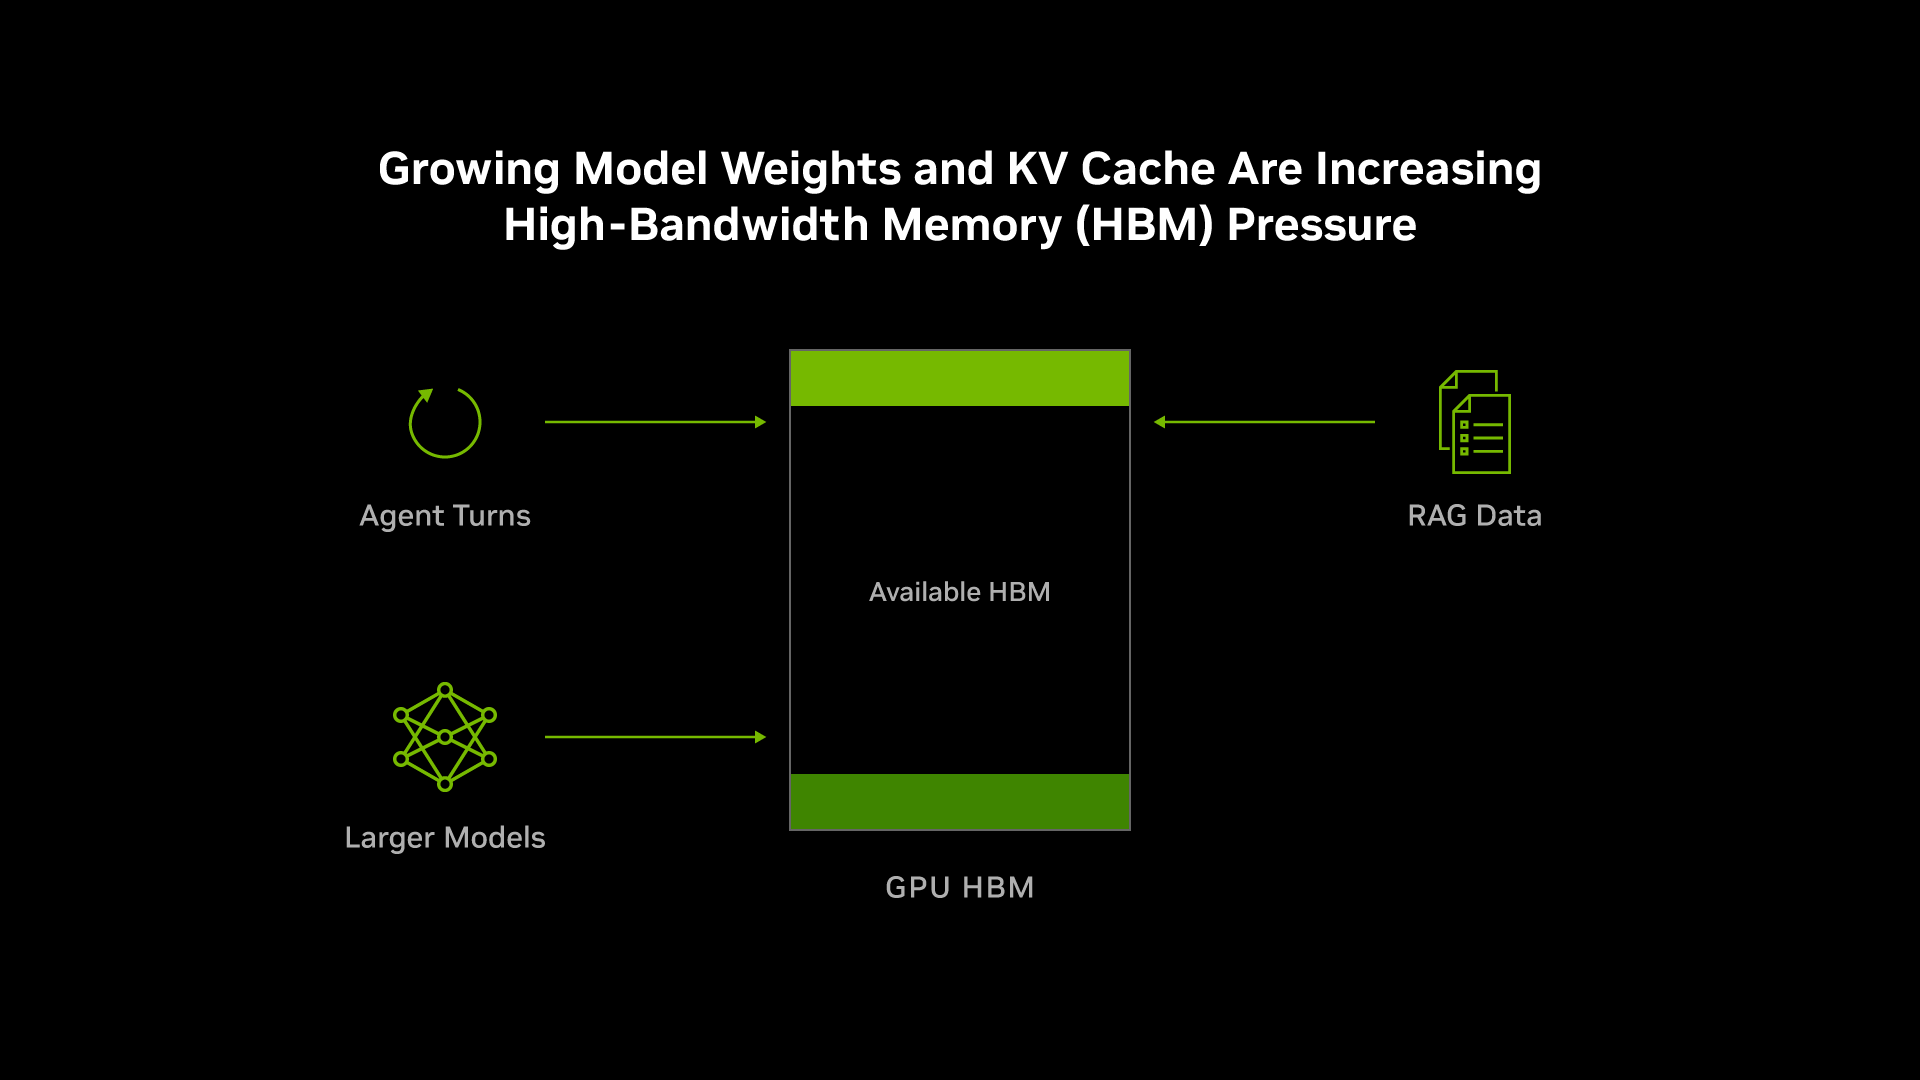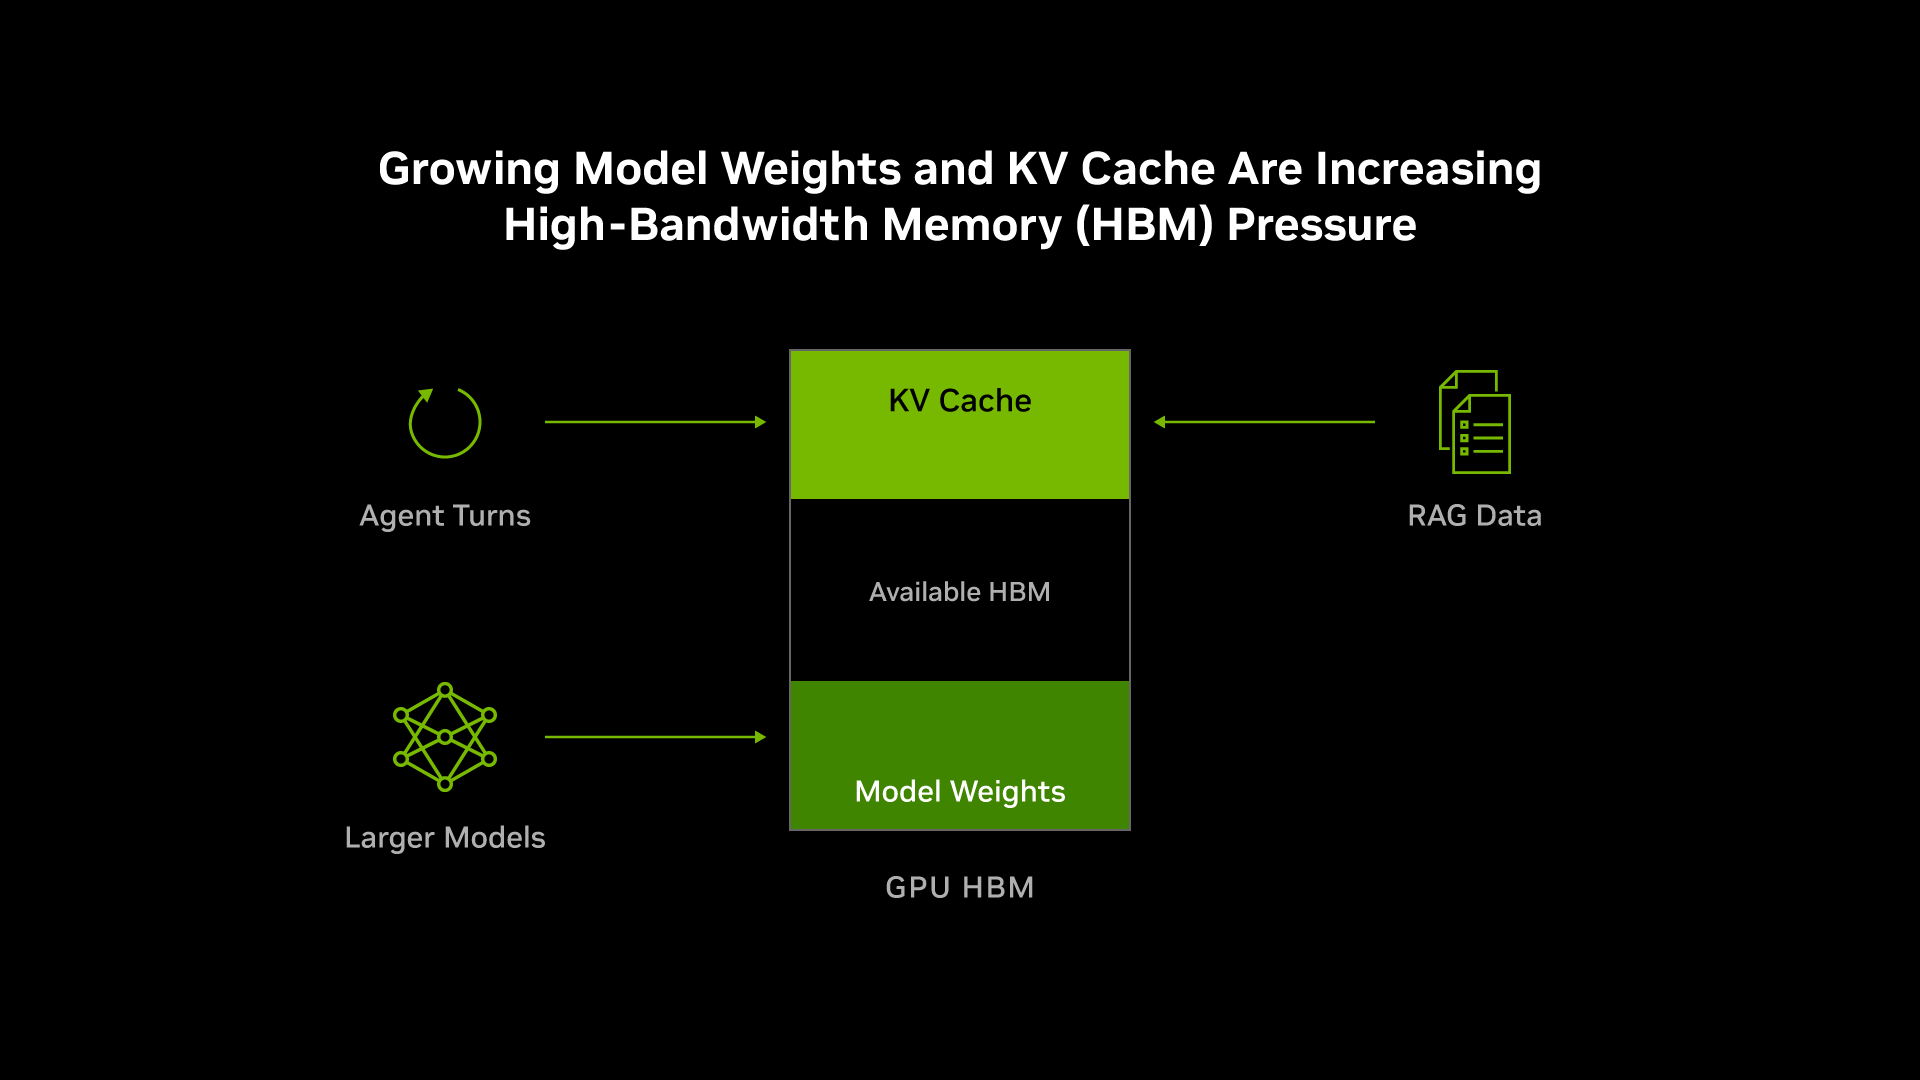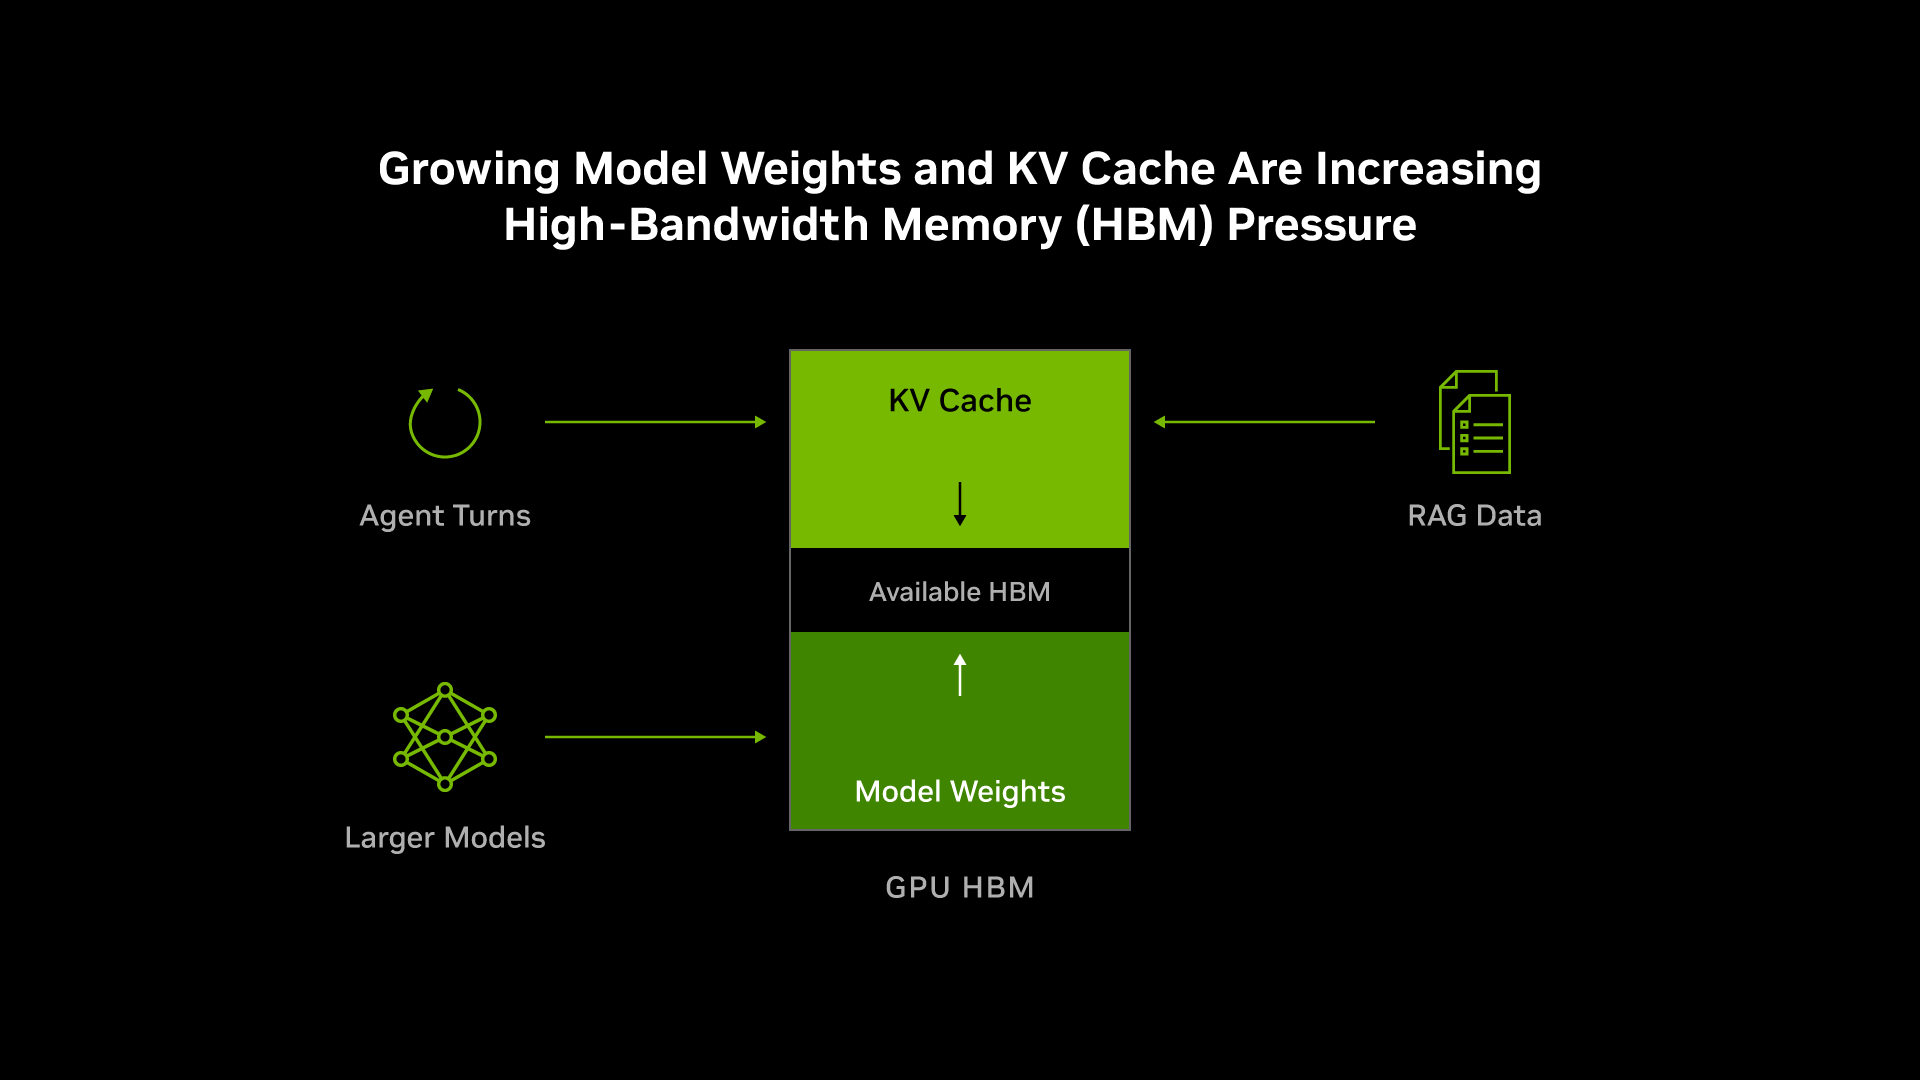
英伟达在11月5日发布技术解读,聚焦AI推理中HBM资源压力。随着大模型参数规模及智能体应用扩展,GPU显存需承载模型权重与KV缓存。部分场景处理多达300万个token,加上检索增强生成(RAG)引入的企业资料,内存占用显著增加,而HBM供应趋紧及价格上升问题在可预见未来将持续。
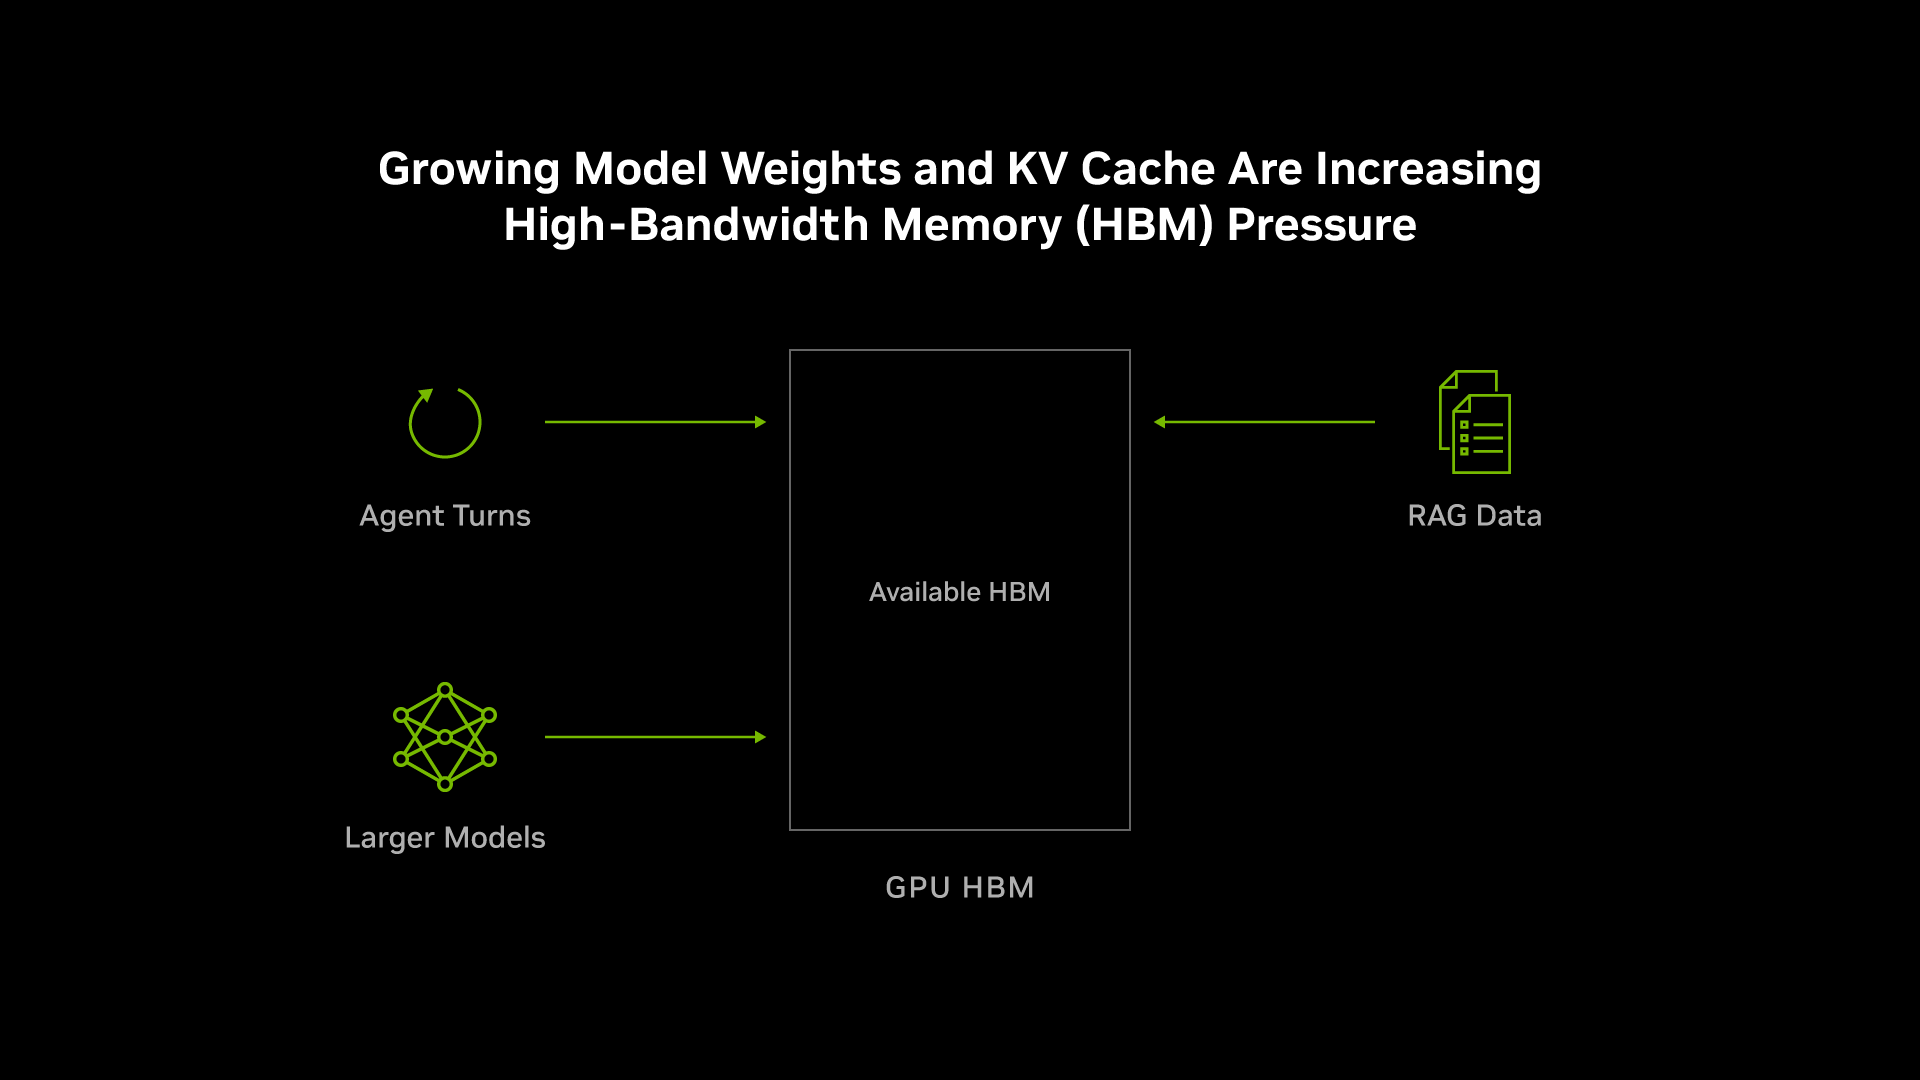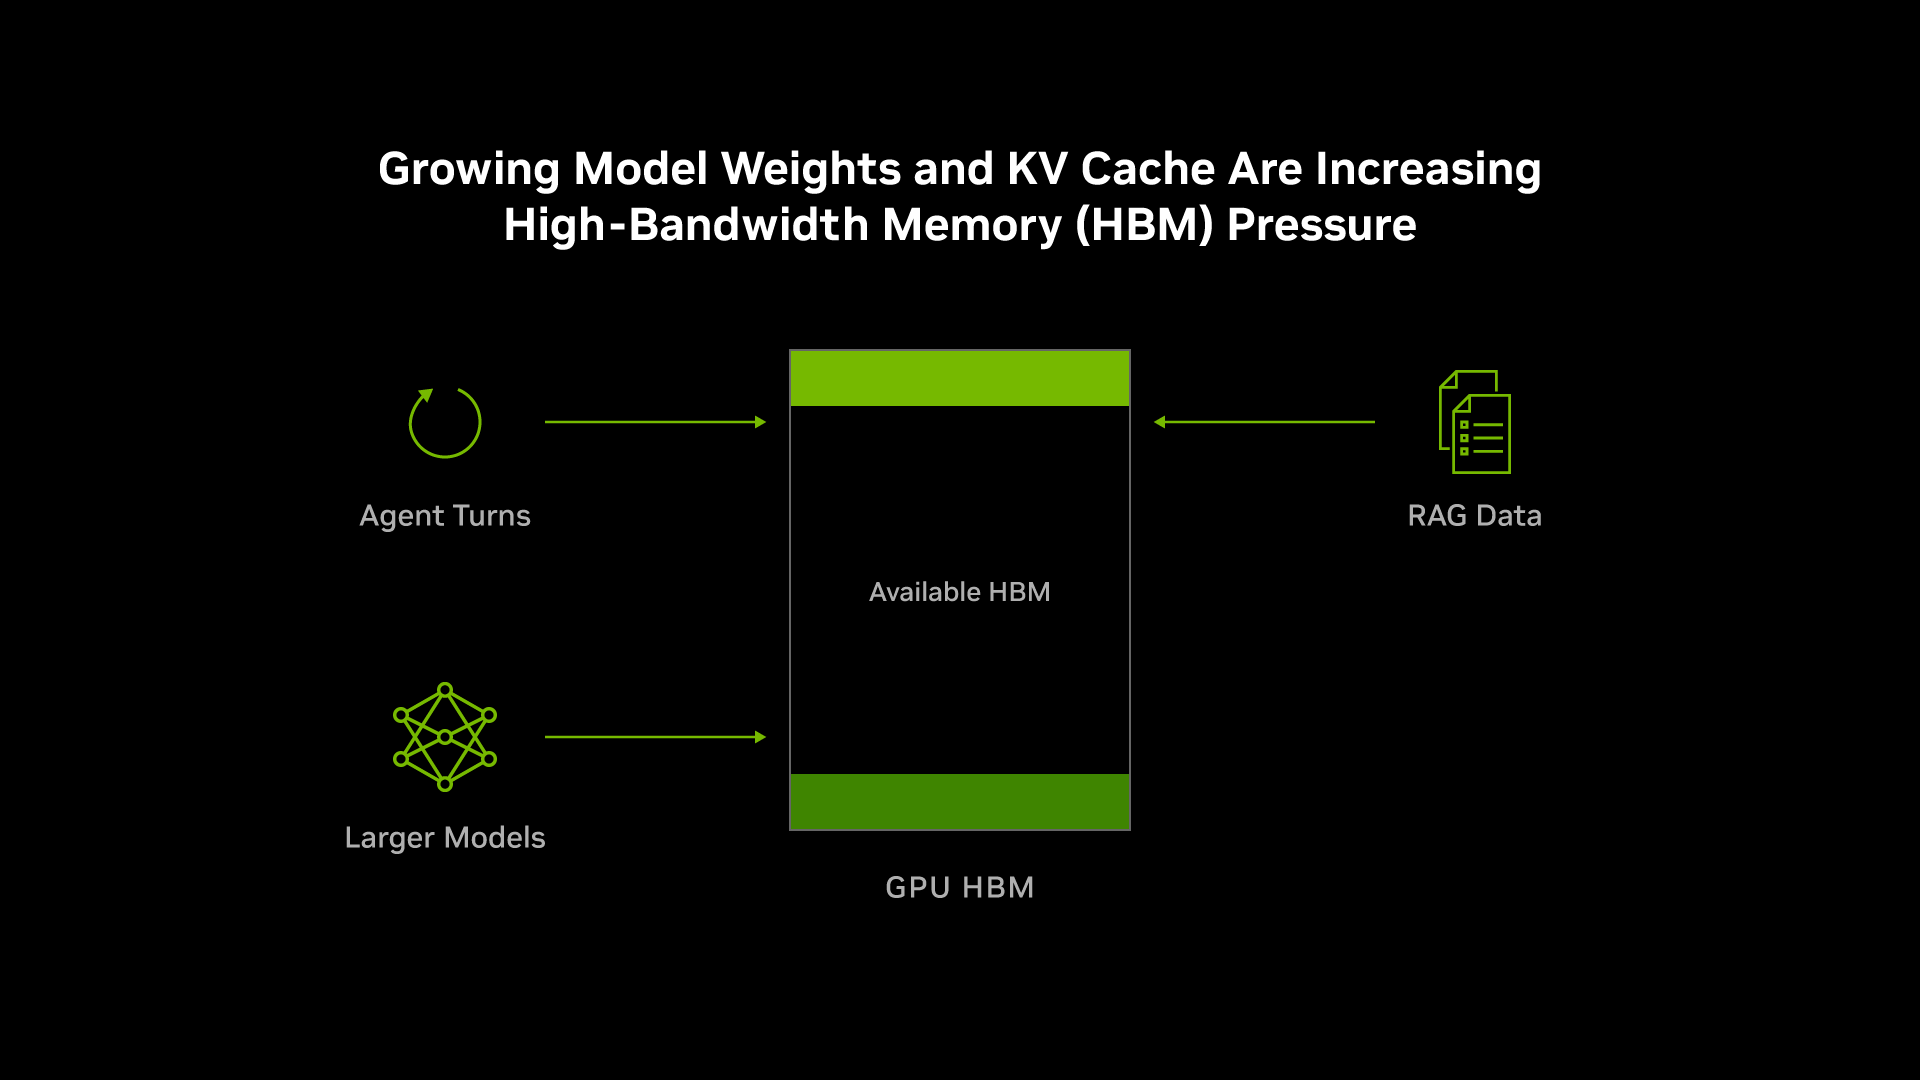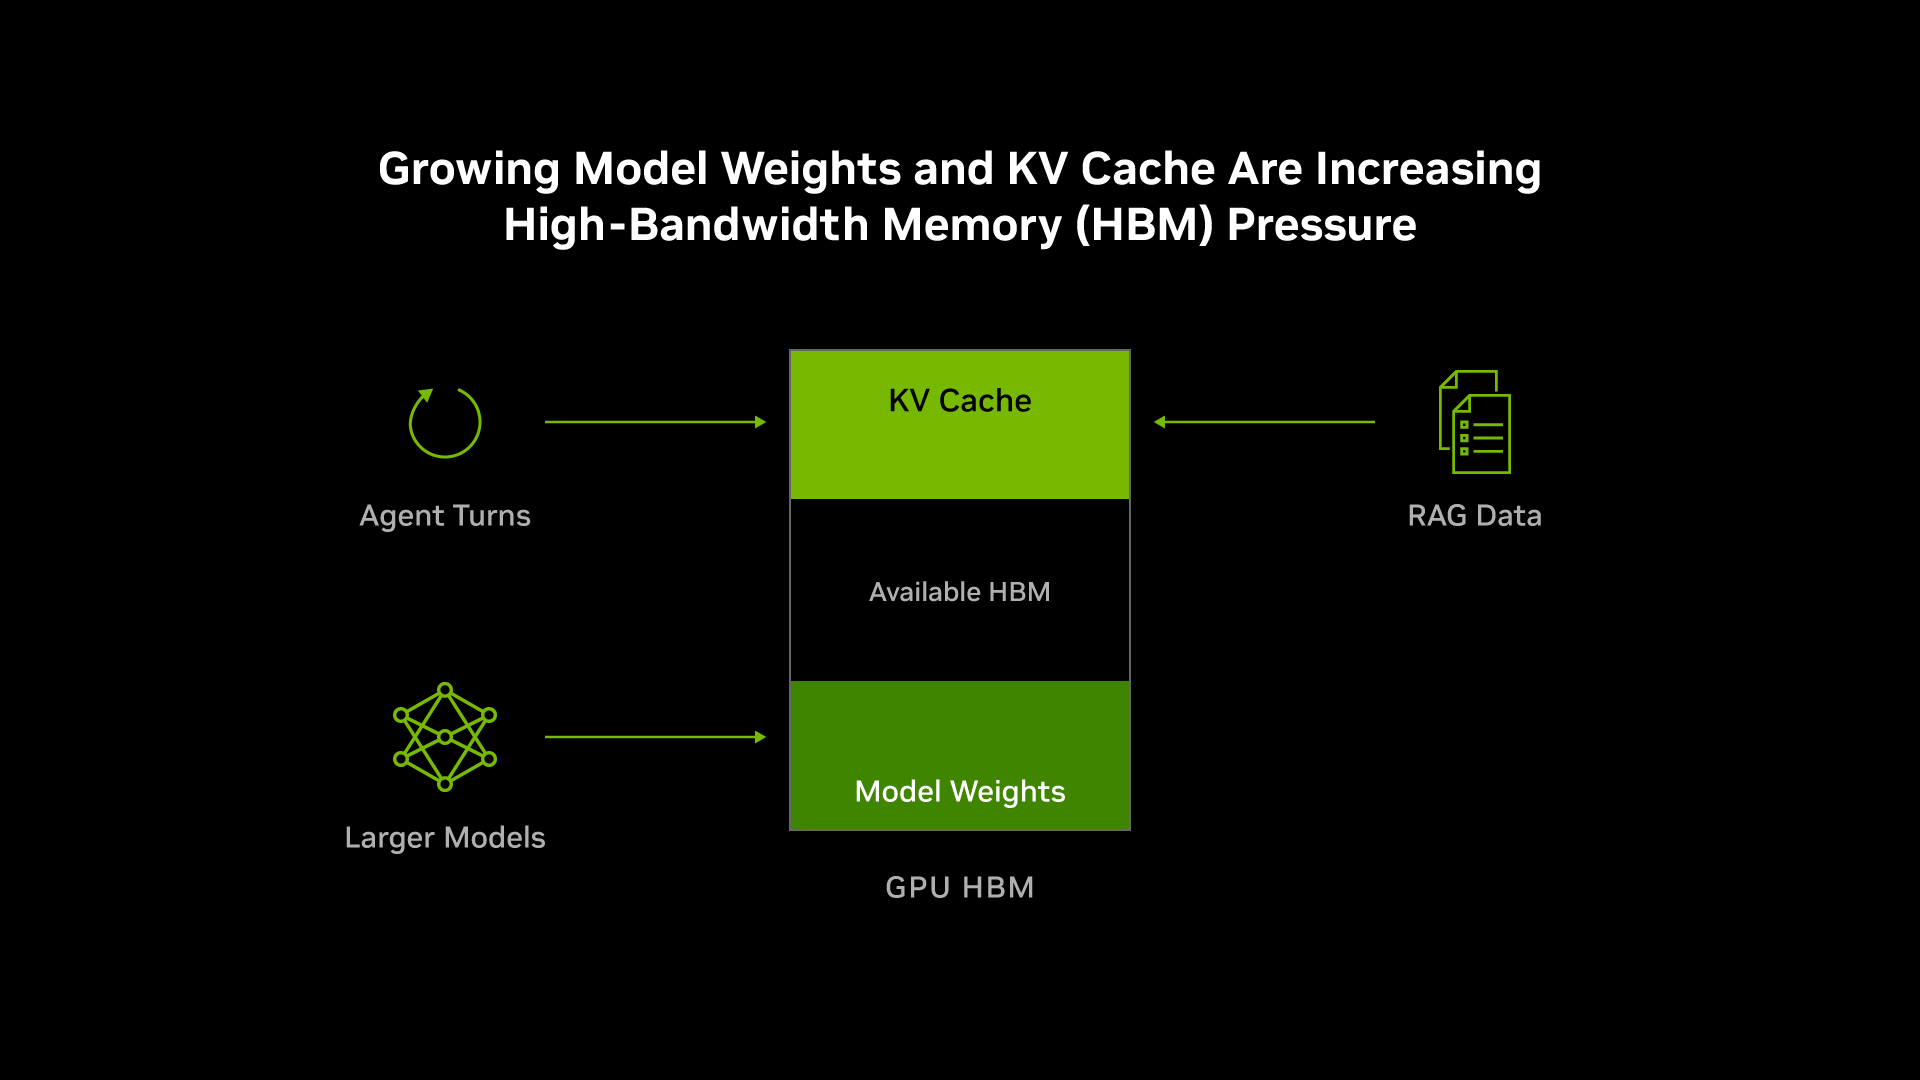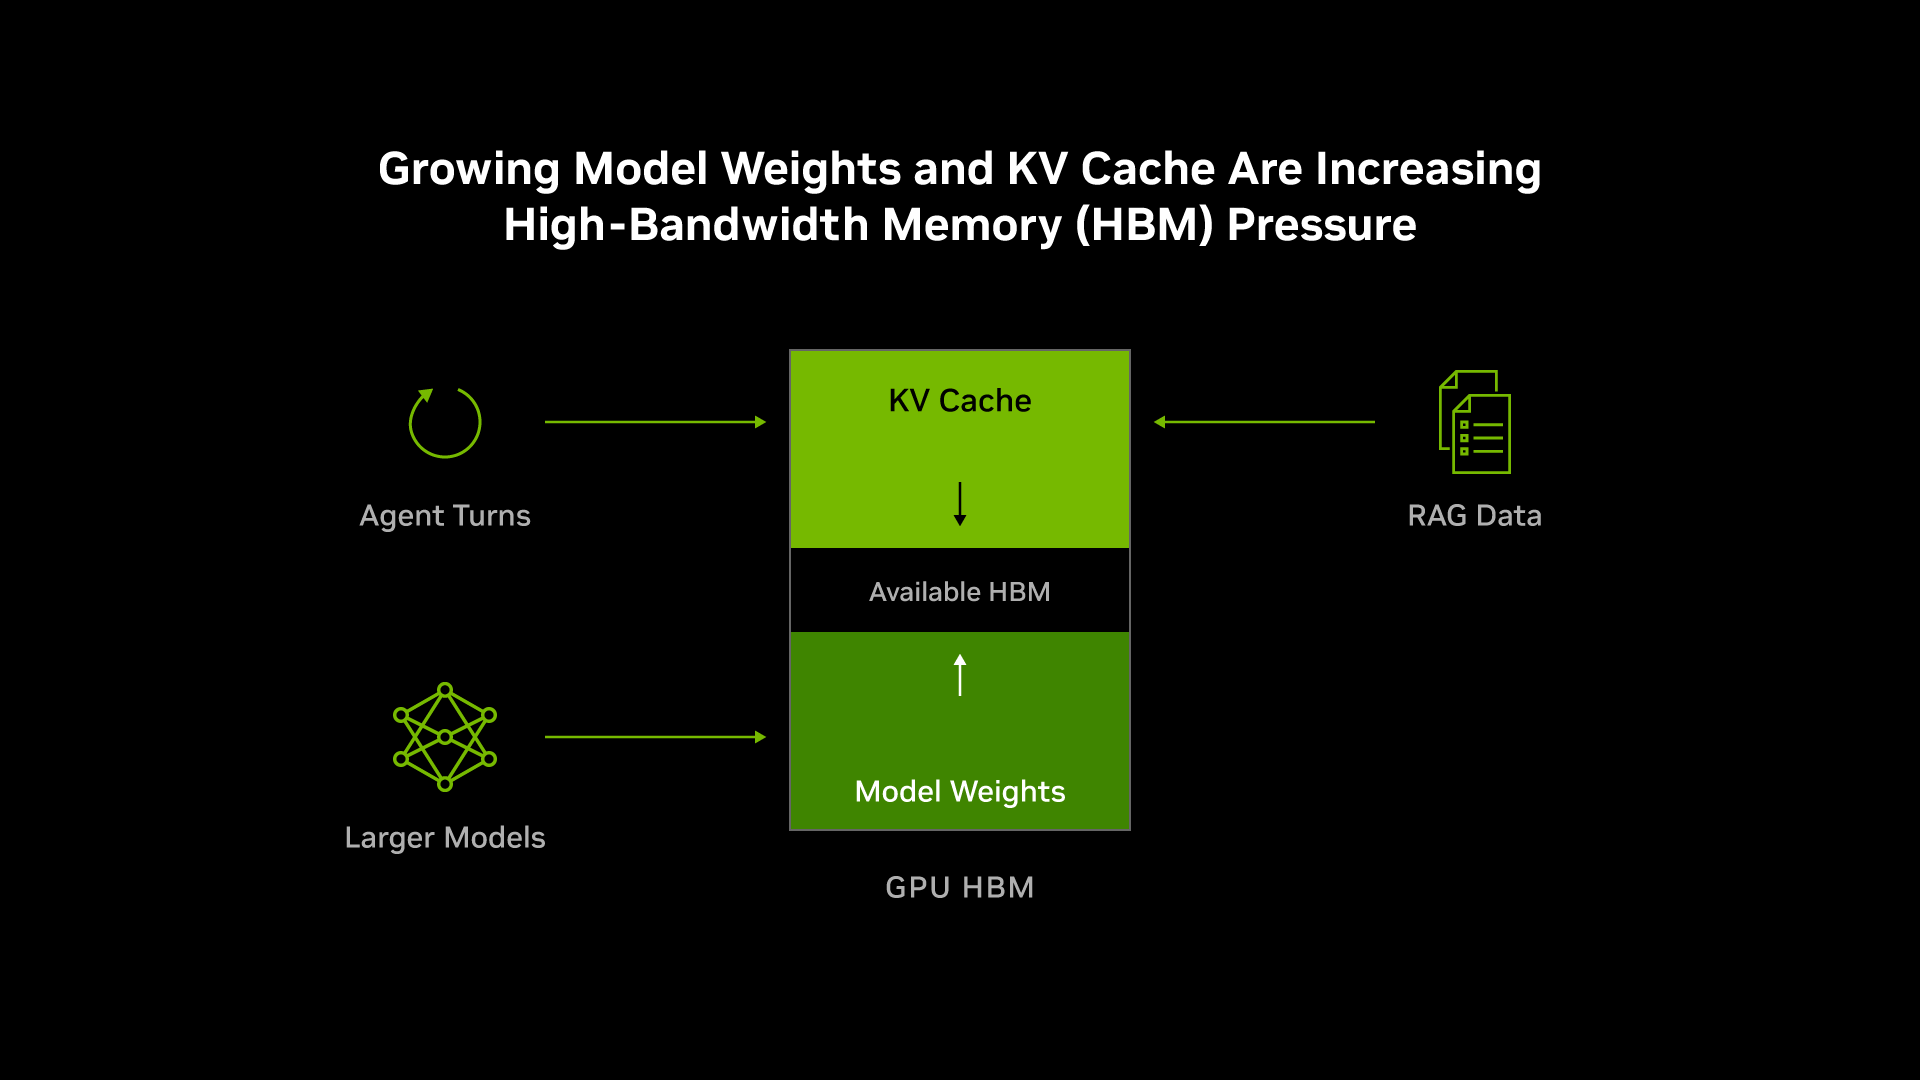
英网传其采用“全栈协同设计”思路,将GPU、CPU、网络、存储和软件作为整体设计,旨在提升内存价值。该方案指出,HBM容量增加若未匹配数据进出速度,将遭遇“内存墙”,新增容量无法有效转化为服务能力。因此,需通过数据压缩及分层调度,确保数据在合适层级高效流动。

操作层面,英伟达结合NVFP4低精度格式压缩权重与KV缓存,利用Vera CPU的大容量LPDDR内存为暂停上下文提供缓冲。在NVL72系统中,模型权重可分散至最多72颗GPU。Dynamo推理软件负责将不活跃上下文迁移至CMX存储,RAG索引则保留在CPU与存储侧,避免长期占用HBM。

据SemiAnalysis AgentX基准数据,在每用户每秒125 token条件下,Vera Rubin NVL72相较GB300 NVL72,每美元智能体吞吐量最高提升30倍,而每GPU的HBM容量仅增加约3%。另一组数据显示,GB300 NVL72较H200平台在每用户每秒100 token条件下,每美元吞吐量最高提升10倍。

AI算力竞争正从单纯追求显存容量,转向追求每字节、每瓦特产出的有效token数量,推理服务的评估标准也随之改变。
THE END
免责声明:本站所使用的字体和图片文字等素材部分来源于互联网共享平台。如使用任何字体和图片文字有冒犯其版权所有方的,皆为无意。如您是字体厂商、图片文字厂商等版权方,且不允许本站使用您的字体和图片文字等素材,请联系我们,本站核实后将立即删除!任何版权方从未通知联系本站管理者停止使用,并索要赔偿或上诉法院的,均视为新型网络碰瓷及敲诈勒索,将不予任何的法律和经济赔偿!敬请谅解!
相关阅读
  • 三星获AMD HBM基础裸片订单,2nm代工落地得州

    三星获AMD HBM基础裸片订单,2nm代工落地得州

    据相关报道,三星晶圆代工业务获得AMD关键订单,后者确定将下一代HBM基础裸片交由三星位于美国得州的泰勒第二座晶圆厂生产。基础裸片作为HBM堆栈底部的逻辑芯片,承担数据传输与控制逻辑职能。随着HBM速……

    前天 18:41
  • HBM走私现新招与低端CPU焊在一起合法出口:单卡利润超16万元

    HBM走私现新招与低端CPU焊在一起合法出口:单卡利润超16万元

    三星与SK海力士生产的HBM正通过一条灰色通道流入第三方市场。走私者利用出口管制的分类漏洞,将HBM与廉价的CPU封装在同一块基板上,以CPU的名义合法申报出口。美国出口规则在评估芯片封装时,以服务器……

    前天 18:38
  • 高通HBC架构完成验证,能效超HBM4五倍

    高通HBC架构完成验证,能效超HBM4五倍

    高通近日宣布,其高带宽计算(HBC)内存架构已完成初步验证。这项技术旨在通过近存计算缩短数据传输距离,以同时提升内存带宽、能效并降低制造成本。HBC架构将多层DRAM堆叠在一颗小型计算芯片上方,使内存更靠近计算单元。

    前天 18:37

栏目精选

  • 技术 英伟达发布全栈协同设计,提升AI推理每美元吞吐量

    英伟达发布全栈协同设计,提升AI推理每美元吞吐量

    英伟达在11月5日发布技术解读,聚焦AI推理中HBM资源压力。随着大模型参数规模及智能体应用扩展,GPU显存需承载模型权重与KV缓存。部分场景处理多达300万个token,加上检索增强生成(RAG)引……

    34分钟前
  • 技术 高通HBC架构完成验证,能效超HBM4五倍

    高通HBC架构完成验证,能效超HBM4五倍

    高通近日宣布,其高带宽计算(HBC)内存架构已完成初步验证。这项技术旨在通过近存计算缩短数据传输距离,以同时提升内存带宽、能效并降低制造成本。HBC架构将多层DRAM堆叠在一颗小型计算芯片上方,使内存更靠近计算单元。

    前天 18:37

企业 更多

新品 更多