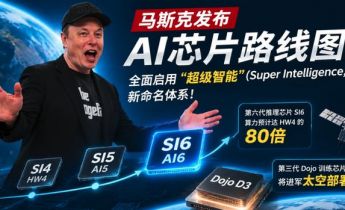
特斯拉正式公布AI加速器路线图,全面启用“超级智能”(Super Intelligence)新命名体系:SI6算力预计提升80倍,Dojo 3将进军太空!
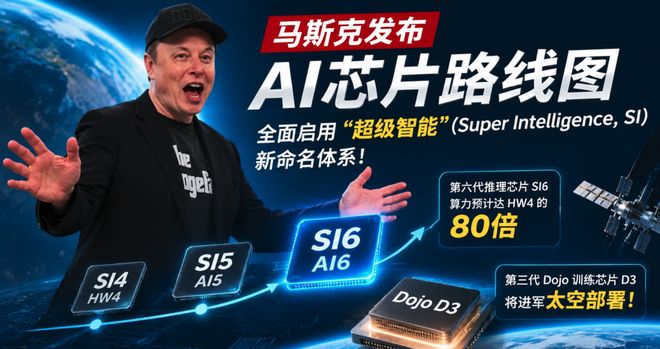
特斯拉为新一代处理器启用“超级智能”(Super Intelligence)这一新称谓,并将这一命名体系追溯应用于此前推出的旧款芯片。
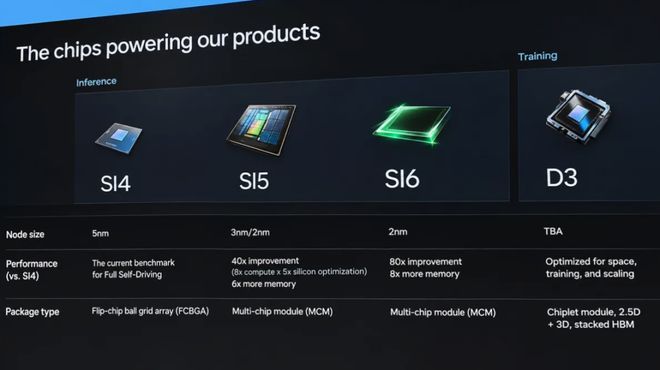
一、特斯拉AI芯片路线图 特斯拉正式披露新一代AI芯片路线图,全面启用“超级智能”(Super Intelligence,SI)命名体系。 其中,第六代推理芯片SI6性能预计达到HW4的80倍,算力最高达46,080 TOPS;训练芯片Dojo D3则转向Chiplet多芯粒架构,采用2.5D/3D封装与堆叠式HBM,并瞄准太空数据中心部署。特斯拉正加速布局自动驾驶、机器人与超级智能计算。 一图看懂特斯拉AI芯片全路线图!
二、Dojo D3:不再采用晶圆级集成?
特斯拉AI硬件路线图中,最值得关注的进展之一,或许是其自主研发的Dojo训练加速器重新回归。
此前,埃隆·马斯克曾于2025年8月取消整个晶圆级Dojo项目。随后在2026年8月,他又表示,SpaceX和xAI将在地面及太空数据中心完全采用英伟达硬件。第三代Dojo将与前两代产品Dojo D1和Dojo D2存在显著差异。
特斯拉将下一代Dojo 3(D3)训练加速器描述为一种基于Chiplet(芯粒)的设计,结合2.5D和3D先进封装技术,以及堆叠式高带宽内存HBM。
这与最初Dojo D1采用的晶圆级系统(System-on-Wafer,SoW)架构有着本质区别。
Dojo D1采用分布式片上SRAM架构,通过晶圆级封装技术,将25颗D1处理器连接在一起,总计配备11GB SRAM。
引入HBM,意味着特斯拉希望大幅提升内存容量。
现代AI模型在存储模型参数、激活值以及中间数据时,需要消耗海量内存。从容量角度来看,SRAM已经不再具备优势。
采用HBM虽然能够简化内存容量扩展,但也会带来不同的延迟、带宽、封装和功耗权衡。
一方面,特斯拉仍然可以利用晶圆级封装技术,将定制HBM模块堆叠在逻辑芯片之上。
另一方面,晶圆级集成成本高昂,通常只适用于特定应用场景,例如以SRAM为核心的芯片架构。
如果在通过晶圆级互连技术连接的逻辑芯片上进一步堆叠HBM,将增加设计复杂性、散热挑战和制造难度,甚至可能降低良率。
此外,这种设计还会带来长期可靠性问题,并最终推高产品成本。
Dojo D3继续采用传统晶圆级集成技术的可能性可能正在降低。Dojo D3将面向太空部署。
目前,特斯拉尚未披露Dojo D3的具体算力、内存容量、制造工艺和开发时间表。特斯拉表示,Dojo D3将针对“空间占用、训练能力和扩展性”进行优化。
这意味着该芯片不仅需要提供足够的计算性能,还需要具备良好的规模化扩展能力。
这一点也进一步暗示,Dojo D3可能采用更加传统的AI加速器架构,而不是此前Dojo D1所采用的晶圆级封装方案。
三、SI6:未来几年算力将达到HW4的80倍
路线图中另一个值得关注的细节,是特斯拉第六代推理加速器SI6的预估计算性能。
根据披露的信息,SI6的计算能力预计将达到HW4的80倍,内存容量则达到HW4的9倍。
根据HW4性能的不同计算口径,SI6的算力预计在17,280—46,080 TOPS之间,也就是17.28—46.08 POPS(每秒千万亿次运算)。
为了方便比较,英伟达Rubin GPU在推理任务中可以提供50 NVFP4 PFLOPS算力,在训练任务中可以提供35 NVFP4 PFLOPS,并支持17.5 FP8/FP6 PFLOPS算力。
英伟达Rubin GPU已经开始向客户出货,而特斯拉SI6预计要到2029—2030年才会推出。
HW4:特斯拉当前的自动驾驶计算平台
特斯拉目前汽车中使用的第四代推理处理器,最初被称为HW4,后来更名为AI4,现在又采用SI4这一名称。
该芯片由三星晶圆代工部门采用7nm级工艺制造,采用传统的倒装芯片球栅阵列封装(FCBGA),并配备16GB GDDR6内存。
特斯拉将SI4视为当前完全自动驾驶(FSD)技术的基准平台,未来几代芯片的性能提升都将以它作为参照。
埃隆·马斯克曾表示,HW4的性能是HW3的3—8倍。
HW3官方标称算力为72 TOPS。据此推算,HW4的算力约为216—576 TOPS。
四、SI5:性能提升40倍,采用台积电3nm和三星2nm
按照此前预期,特斯拉即将推出的第五代推理加速器将被命名为SI5,也就是此前所称的HW5或AI5。
最新路线图再次确认,SI5将分别由台积电和三星晶圆代工部门制造,采用3nm和2nm级工艺技术。
与HW4采用的传统封装方式不同,SI5将采用多芯片模块(MCM)设计。
根据埃隆·马斯克此前透露的信息,特斯拉预计SI5的性能将达到HW4的40倍。
第一,计算能力提升8倍。更先进的制造工艺以及更多执行单元,将显著提升芯片的计算能力。第二,通过芯片设计和硅片优化,实现额外5倍的性能增益。两者结合,最终实现40倍的性能提升。
按照HW4不同的算力计算口径,SI5预计可以达到8,640—23,040 TOPS。
在功耗方面,SI5预计将达到250W—800W,具体取决于实际应用场景。
因此,在产品尚未正式推出之前,对其性能进行精确估算并没有太大实际意义。
内存方面,SI5的容量预计达到上一代产品的6倍,即96GB。
根据最终采用GDDR6还是GDDR7内存,其内存带宽预计可以达到768GB/s至1.536TB/s。
五、SI6:2nm工艺,144GB内存,性能达到HW4的80倍
再来看特斯拉第六代推理加速器SI6。
与SI5相比,SI6将进一步提升计算性能。
根据路线图,SI6的计算性能预计达到HW4的80倍,内存容量则将达到当前一代处理器的8倍。
按照文章中的估算口径,其算力可能达到17.28—46.08 POPS,即每秒17.28—46.08千万亿次运算。内存容量预计达到144GB。
三星将负责SI6制造,合作持续至2033年特斯拉已经与三星晶圆代工部门签署协议,由三星负责生产第六代推理加速器,合作期限持续至2033年。
最新披露的路线图显示,SI6将采用2nm级工艺制造。
考虑到该芯片预计在2029—2030年推出,再结合三星近期更新的晶圆代工路线图,文章认为,SI6可能采用以下几种工艺:
SF2A:面向汽车应用的2nm工艺。
SF2P:性能增强型2nm工艺。
SF2Z:采用背面供电技术的2nm工艺。
另一个值得注意的细节是,特斯拉似乎并未计划在2030年代通过其Terafab工厂,采用英特尔14A工艺生产SI6。
SI6将继续沿用第五代推理加速器AI5/SI5/HW5引入的多芯片模块(MCM)架构。
通过SI5的研发和制造,特斯拉可以积累多芯片设计与封装经验,并将这些经验应用于SI6,同时将封装成本控制在相对合理的水平。
目前,许多汽车制造商也在考虑为下一代系统级封装(SiP)引入多芯粒设计和HBM内存。不过,这种方案也会进一步推高芯片成本。
至于特斯拉何时会在推理加速器中引入HBM,目前仍然没有明确答案。