在上海举办的国芯展上,东方算芯宣布基于DF1000打造的首个全国产大规模训练集群正式交付。该集群规模为128卡,是3D大算力芯片首次在此规模完成稳定性验证。测试数据显示,集群连续训练72小时无中断,千亿参数级Step 130B大模型仅用7天完成训练适配。从项目立项到集群具备训练能力,整个周期为24个月。按计划,东方算芯将于年底交付千卡级集群。
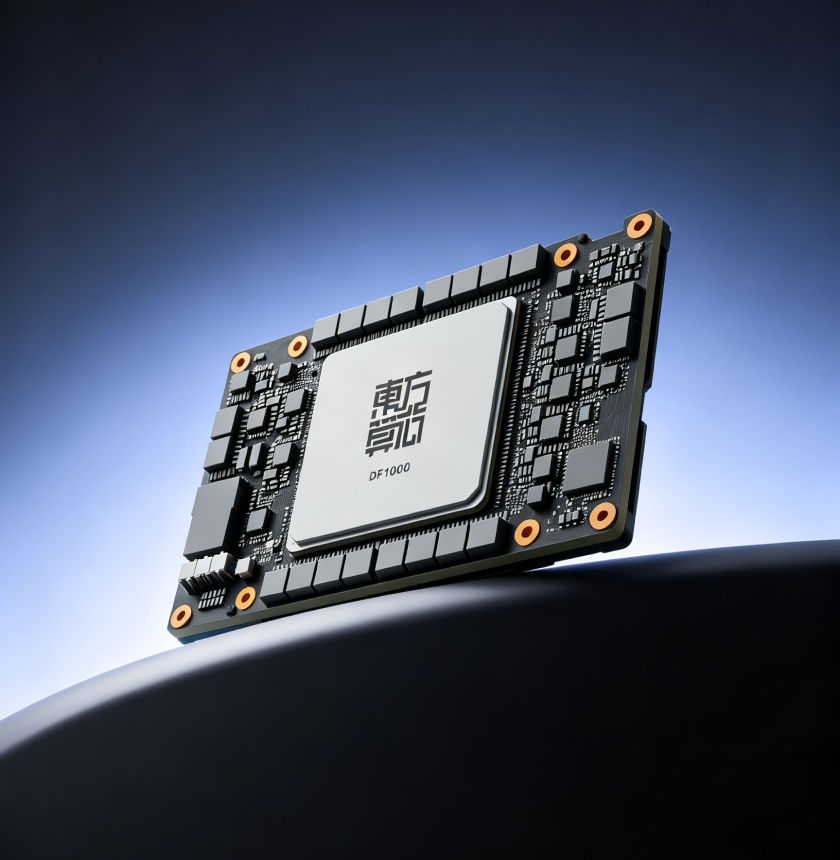
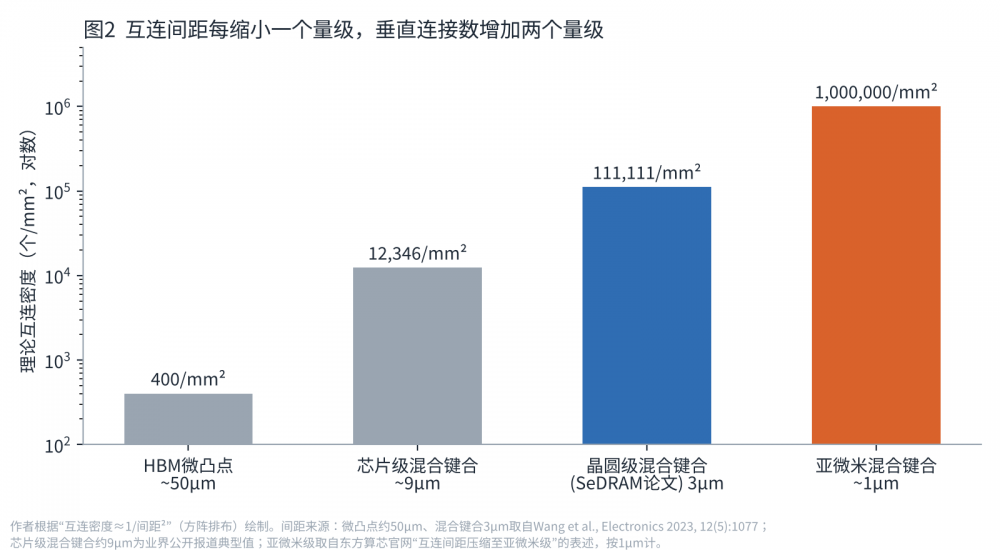
DF1000是国内首颗采用DRAM-Logic晶圆级混合键合3D垂直集成的AI算力芯片。其规格显示,BF16算力为520 TFLOPS,访存带宽达6.4TB/s,单位算力对应的带宽约为主流GPU的2至3.6倍。该架构通过混合键合将互连间距压缩至亚微米级,在不依赖HBM和先进制程的前提下,实现了高带宽与高密度互连。在14nm工艺下,DF1000同等容量带宽可达HBM方案的5倍以上。
在软件架构上,DF1000采用软件定义计算架构,通过数据流驱动的粗粒度Tile计算引擎,支持FP32、FP16、BF16、FP8、FP4等多种精度。该设计解决了硬件与算子不匹配、数据等待及单元空闲问题,使计算效率提升至85%以上。集群层面,DF1000遵循OAM 2.0规范,提供风冷和液冷版本,并配套擎元QY100单机8卡服务器及拓域TY64 64卡液冷超节点,超节点基于标准以太网构建,降低了供应链风险。
在先进制程受限的背景下,通过3D垂直集成提升互连密度以突破内存墙,成为国产AI芯片实现算力突围的有效路径之一。