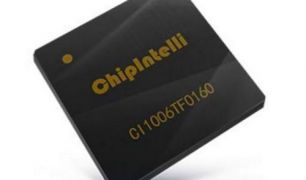
作为观察中国工控产业升级的核心风向标,2026上海工博会集中释放了智能制造技术迭代的最新信号,边端算力与工业生产场景的深度融合,正是当下行业发展的核心主线。在本届展会上,爱芯元智以“智造无界,算力抵达”为主题亮相,正式发布专为大模型边端侧落地打造的大算力AI芯片AX8860系列,同步展出从核心芯片、模组到推理卡、推理服务器的全形态产品矩阵。
展会期间,爱芯元智创始人&董事长仇肖莘博士与边缘、终端计算产品线总经理刘瑞聚接受媒体采访,围绕产品设计逻辑、多赛道战略布局、工业落地路径与生态边界等核心话题,拆解了边端 AI 从技术验证走向规模化落地的产业逻辑。
在行业普遍追逐峰值算力参数的当下,AX8860系列芯片集256TOPS混合精度算力,原生支持FP4精度,搭配273GB/s内存带宽与128GB LPDDR5X大容量内存,同时具备64路视频解码、16路视频编码能力,采用6nm先进工艺制程,在算力、带宽、内存容量与功耗之间实现了系统性平衡,满足智能制造、仓储物流等场景对端边大算力的严苛需求。
“AX8860是一款在各项设计指标上实现综合均衡的芯片。如果孤立拔高某一项指标,就容易形成性能短板,而芯片整体性能恰恰由短板决定。”仇肖莘说道。作为专为大模型边端侧落地打造的大算力AI芯片,AX8860并非只以峰值参数为目标,而是聚焦模型部署、现场推理和系统协同等实际需求,为物理AI应用提供更完整的算力底座。
在芯片定义阶段,爱芯元智团队观察到大模型轻量化的明确趋势,过去需要千亿、万亿参数模型才能实现的推理精度,如今千问 27B、35B-A3B等模型即可达到同等效果。基于这一判断,团队将“原生支持8B、9B、27B主流边缘大模型”作为核心目标,同时设定30Token/s的吞吐门槛,通过多轮仿真验证最终确定算力与带宽规格。
AX8860采用面向大模型推理优化的自研架构,算力利用率可达80%,同等峰值算力条件下,Prefill阶段性能能够实现2倍提升。针对边缘场景多芯片协同需求,AX8860支持AXLink级联技术与 PCIe 5.0高速互联,将DDR访问延迟控制在合理区间,高效支撑芯片级联下的内存池化,为工业场景多算力节点扩展提供了可行路径。
围绕AX8860,爱芯元智同步发布了元曦模组A256S,并亮相元曦系列推理卡和推理服务器。A256S采用模块化设计,具备体积小、算力强、落地快等特点,支持LLM、VLM和Omni等多类模型应用,能够为核心算力与应用硬件之间提供更灵活的组合方式,帮助客户加速产品研发落地。
边缘AI市场高度碎片化,工业、车载、视觉、机器人等细分赛道需求差异显著,依靠单一芯片覆盖全部市场并不现实。“爱芯元智始终将自己定位为边缘AI算力芯片厂商。”仇肖莘指出,面对碎片化场景,爱芯元智的思路是提炼各场景的共性能力,搭建统一技术底座,即由ASP IP、NPU IP、编解码IP等一系列IP构成的技术工具箱。切入不同细分场景时,只需从工具箱中选取并组合不同IP,即可快速配置出适配该领域的专用芯片,用相对可控的研发投入支撑多条赛道并行发展。
针对不同赛道的发展阶段与竞争格局,爱芯元智采取了差异化的竞争策略。在成熟的视觉处理赛道,爱芯元智坚持技术驱动的中高端路线,单芯片可支持多路视频与CMOS传感器接入,搭载AI ISP算法,在复杂光照环境下保障高质量图像采集;在车载赛道,凭借完备的产品矩阵与技术领先性构建壁垒,爱芯元智已率先落地5nm工艺,将单芯片算力提升至700多TOPS,同时布局入门级高性价比产品与高端旗舰芯片,覆盖不同层级车企需求;在尚处起步期的边缘计算赛道,爱芯元智此次发布的AX8860定位高端产品,未来也将持续迭代产品矩阵,紧跟客户需求演进。
在三大业务稳步推进的同时,爱芯元智已经开始布局第四条增长曲线。面向未来,机器人已被公司列为重点发力的方向。仇肖莘判断,机器人行业当前仍处于早期阶段,出货规模尚小,但属于确定的未来赛道。目前爱芯元智已有三条产品线实现规模化量产,同时这些产品线也在为面向机器人领域的产品做技术储备,覆盖机器人“大脑”、“小脑”、视觉模组三大核心需求,从视觉数据采集到运动控制再到高阶决策,形成多维度支撑。
完整的产品矩阵与前瞻的技术储备,最终都要落地到真实的工业场景中。随着边端AI向工业场景渗透,行业正面临从技术验证向规模落地的关键转型,这一过程中暴露出的时延、部署效率、稳定性等痛点,也成为考验芯片企业综合能力的核心标准。工业产线检测、机器人控制等场景对时延要求极高,缺陷识别与动作指令需在毫秒级完成。不同工业产线对应定制化模型,部署周期直接影响落地效率。而工业现场严苛的环境,对硬件稳定性也提出了远高于消费级的要求。
针对这些行业共性痛点,爱芯元智从多维度给出了系统解法。在时延优化上,爱芯元智提供的面向智能视觉处理的芯片,可支持1200万至1600万像素高分辨率工业检测相机,单颗芯片自带最高18TOPS算力,大量检测推理可在本地端直接完成。生成的检测信号再传输至边缘计算设备,由边缘计算服务器完成后续决策与指令下发,形成低时延闭环,满足产线缺陷快速检测、分流的实时需求。
在模型部署效率上,不同工业产线对应的模型各不相同,属于场景定制化模型,因此模型快速部署能力至关重要。倘若部署任意一个垂类模型都需要数月甚至一年周期,商业化落地就无从谈起。如何帮助客户把专用模型快速部署到爱芯元智的平台,并接入自身生产流程是关键。而在稳定性方面,由于工业场景对可靠性要求严苛,爱芯元智在芯片设计上预留了充足冗余,包含宽温域适配、各类防护设计,可适配工业现场复杂的运行环境。
在生态构建上,爱芯元智坚持Tier2定位,明确自身业务边界。“爱芯元智专注芯片研发,始终定位为边缘推理芯片基座产品的平台型企业,不涉足上层算法开发。”仇肖莘表示,清晰的业务边界让算法厂商、系统集成商可以安心合作,无需担心与芯片厂商形成竞争,这也恰好契合了产业软硬解耦的发展趋势。随着行业成熟,终端客户更倾向于自主选择算法与硬件平台,避免被单一供应商锁定。
此次展会上,爱芯元智合作伙伴原力灵机也带来了自研的DM0.5通用具身大脑,集中展示了接口插拔质检、通用工业插入和灵巧手柔性切削三个任务,生动呈现了具身智能在电子装配、精密制造、工业质检及柔性加工等场景中的应用潜力。作为本次展示的智能核心,DM0.5依托爱芯大算力平台完成模型推理,为三类任务提供了统一的智能支撑。
如今,边端AI的竞争早已脱离单纯的参数比拼,转向场景适配能力与生态协同深度的综合较量。随着国产算力底座的持续成熟与产业生态的不断完善,数据在现场产生、计算在现场完成、决策在现场执行的智能生产图景正加速落地,边端算力也将真正成为驱动制造业高质量发展的新质生产力。而以爱芯元智为代表的本土芯片企业,也将持续以扎实的技术积淀与开放的产业生态,为智能制造升级注入源源不断的边端算力动能。